关键信息
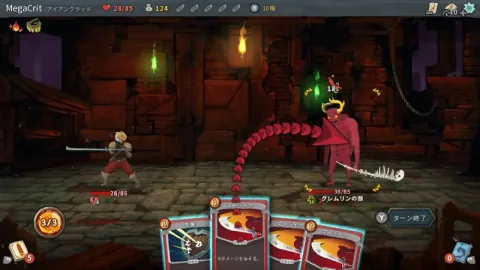
Sander W. Keemink和Scott C. Lowe最近的一项预印本研究评估了20个大语言模型(LLM)游玩《杀戮尖塔》“进阶20”难度的表现。
虽然一些模型成功通关了第一幕,但在后期阶段表现显著下降,在所有试验中仅有一个模型成功击败了最终BOSS。 研究人员利用名为SpireBench的自定义环境,使LLM能够直接与游戏进行交互。 为了减轻先验知识的影响,研究替换了游戏内的术语。
通过与Mega Crit的历史数据及四位资深主播的表现进行对比,研究发现,尽管顶级LLM在短期战斗中可以胜过普通玩家,但仍无法达到人类专家的熟练程度。 研究将LLM的失败归因于其过于谨慎的游玩风格。 模型优先考虑即时的生命值保存,频繁选择休息而非强化卡牌,并避开精英怪遭遇。
此外,LLM倾向于获取过多的卡牌,导致卡组臃肿。 这些行为与平衡风险和长期成长的专家策略形成了鲜明对比。 作者承认了研究的局限性,包括样本量较小以及无法完全排除通用的卡组构建知识。 尽管存在这些限制,研究结果仍强调了即使是先进的AI模型,在掌握游戏最高难度所需的复杂且高风险的决策方面也面临困难。