핵심 정보
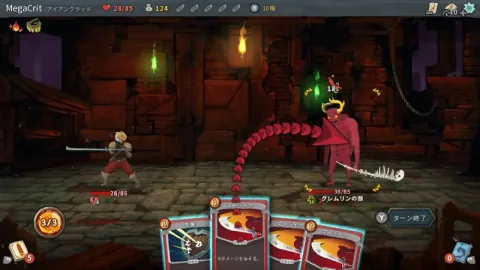
Sander W. Keemink와 Scott C. Lowe가 진행한 최근 사전 인쇄 연구에서는 20개의 거대 언어 모델(LLM)이 '슬레이 더 스파이어'의 승천 20 단계를 플레이하는 것을 평가했습니다.
일부 모델은 1막을 성공적으로 통과했지만, 후반 단계로 갈수록 성능이 크게 떨어졌으며, 모든 시도에서 최종 보스를 처치한 모델은 단 하나뿐이었습니다. 연구진은 LLM이 게임과 직접 상호작용할 수 있도록 SpireBench라는 맞춤형 환경을 활용했습니다. 사전 지식을 배제하기 위해 연구에서는 게임 내 용어를 교체했습니다.
성능은 Mega Crit의 과거 데이터 및 4명의 베테랑 스트리머와 비교되었으며, 상위 LLM이 단기 전투에서는 일반 플레이어보다 뛰어날 수 있지만 전문가 수준의 인간 숙련도에는 미치지 못한다는 사실이 밝혀졌습니다. 연구는 LLM의 실패 원인을 지나치게 신중한 플레이 스타일로 돌렸습니다. 모델들은 즉각적인 체력 보존을 우선시하여 카드 강화보다 휴식을 자주 선택하고 엘리트 조우를 피했습니다.
또한 LLM은 너무 많은 카드를 획득하여 덱을 비대하게 만드는 경향이 있었습니다. 이러한 행동은 위험과 장기적인 성장의 균형을 맞추는 전문가의 전략과는 대조적입니다. 저자들은 작은 표본 크기와 일반적인 덱 빌딩 지식을 완전히 배제할 수 없다는 점을 포함한 한계를 인정합니다. 이러한 제약에도 불구하고, 이번 연구 결과는 고급 AI 모델조차도 게임의 최고 난이도를 마스터하는 데 필요한 복잡하고 위험 부담이 큰 의사결정에 어려움을 겪는다는 점을 강조합니다.