关键信息
模组制作者开发出了一些技术,可以绕过 NVIDIA GeForce RTX 20、30 和 40 系列显卡的固件限制,从而有效地将计算性能提高一倍。 这些修改针对的是消费级 GPU 的指令发布速率,这些 GPU 与专业级硬件共享硅片。
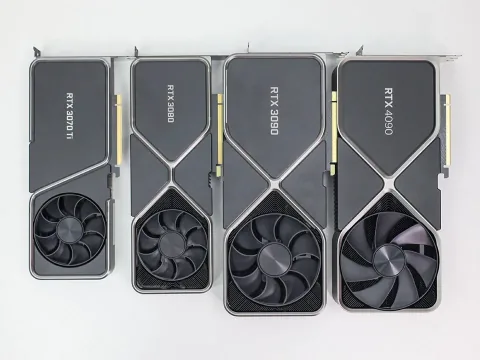
基于 Ampere 架构的 RTX 30 系列显卡(特别是使用 GA102、GA103、GA104 和 GA106 核心的显卡)在矩阵乘法方面表现出显著的提升。 例如,RTX 3090 Ti 在 BF16 运算(神经网络任务的关键)中实现了高达 80% 的性能提升。
对于包括 AD102、AD103 和 AD106 芯片在内的 Ada Lovelace RTX 40 系列,此次解锁使 FP16 和 BF16 张量吞吐量实现了 2 倍的提升。 在 RTX 4090 上的测试显示,性能从 165.6 TeraFLOPS 增加到 331.6 TeraFLOPS,达到了通常仅限于 RTX 6000 等专业显卡的性能水平。
这些修改保持了与 NVIDIA 原厂驱动程序的兼容性,并能通过驱动程序检查。 虽然增加的计算能力有利于本地大语言模型等任务,但用户必须在启动时启用这些模组。 此外,这些更改会使 GPU 保修失效。