关键信息
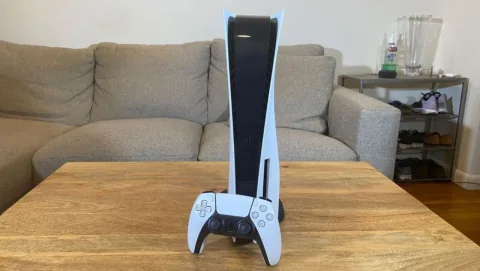
Reddit用户u/AdIllustrious7246发布了一个名为PS5LM的分支版本,这是llama.cpp的一个移植版,旨在让越狱后的PlayStation 5主机能够本地运行大语言模型。 这一进展标志着重大突破,通过利用主机的GPU实现了原生执行,相比以往依赖CPU负载的方法有了显著提升。
该项目利用RADV图形驱动程序的移植版PS5_Vulkan,绕过了主机AMD GPU的标准限制。 通过将处理任务从CPU转移到GPU,系统现在能够以每秒20个Token的速度处理Qwen3.8-27B等大型模型,而Llama 3.2 3B等较小模型则可达到每秒124个Token的速度。
原生执行提供了对11.4 GiB内存的访问权限,这比之前仅限CPU的负载所带来的6.25 GiB限制有了显著增加,此前旧方法还存在系统不稳定的风险。 更新后的软件包含一个用于监控功耗、温度和内存分配等指标的仪表板,并支持通过外部浏览器进行交互的Web UI。
尽管这是一项技术成就,但观察人士指出,受限于PS5的硬件规格(特别是总内存和GPU速度),该项目不太可能对更广泛的AI行业产生影响。 虽然一些评论者对潜在的硬件需求表示担忧,但该主机并不具备专业数据中心设备的性能配置。