要点
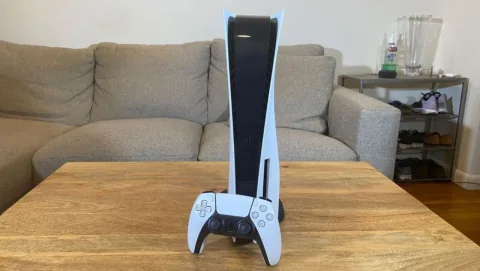
Redditユーザーのu/AdIllustrious7246氏が、脱獄済みPlayStation 5コンソール上で大規模言語モデルをローカル実行するために設計されたllama.cppのポートである「PS5LM」のフォーク版をリリースしました。 この開発により、CPUベースのペイロードに依存していた従来の手法から大きく進歩し、コンソールのGPUを活用したネイティブ実行が可能になりました。
このプロジェクトは、RADVグラフィックスドライバーのポートである「PS5_Vulkan」を利用して、コンソールのAMD製GPUに対する標準的な制限を回避しています。 処理をCPUからGPUに移行することで、システムはQwen3.8-27Bのような大規模モデルを毎秒20トークンで処理できるようになり、Llama 3.2 3Bのような小型モデルでは毎秒124トークンの速度を実現しています。
ネイティブ実行により11.4 GiBのRAMへのアクセスが可能となり、システム不安定化のリスクがあった従来のCPU専用ペイロードによる6.25 GiBの制限から大幅に増加しました。 更新されたソフトウェアには、消費電力、温度、メモリ割り当てなどの指標を監視するためのダッシュボードが含まれており、外部ブラウザ経由での操作を可能にするWeb UIもサポートしています。
技術的な成果であるにもかかわらず、専門家はPS5のハードウェア制限、特に総RAM容量とGPU速度を考慮すると、これが広範なAI業界に影響を与える可能性は低いと指摘しています。 一部のコメント投稿者はハードウェアへの負荷を懸念していますが、このコンソールは専門的なデータセンター機器のような性能プロファイルを備えていません。