要点
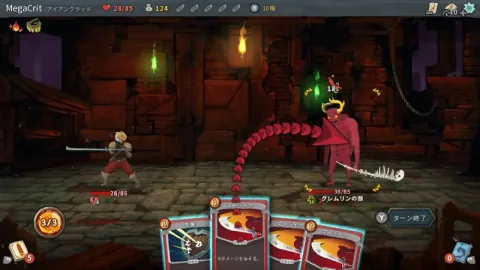
Sander W. KeeminkとScott C. Loweによる最近のプレプリント研究では、20種類の大規模言語モデル(LLM)が『Slay the Spire』の昇天20をプレイする様子が評価されました。
一部のモデルは第1幕をクリアできたものの、後半のステージではパフォーマンスが著しく低下し、すべての試行を通じて最終ボスを撃破できたモデルはわずか1つでした。 研究チームは、LLMがゲームと直接やり取りできるように「SpireBench」というカスタム環境を利用しました。 事前知識の影響を軽減するため、研究ではゲーム内の用語を置き換えています。
パフォーマンスはMega Critの過去のデータおよび4人のベテランストリーマーと比較され、トップクラスのLLMは短期的な戦闘では平均的なプレイヤーを上回る可能性があるものの、熟練した人間の能力には及ばないことが明らかになりました。 この研究は、LLMが失敗する原因を、その過度に慎重なプレイスタイルに帰しています。 モデルは即座のHP維持を優先し、カードの強化よりも休息を頻繁に選択し、エリートとの遭遇を避けました。
さらに、LLMはカードを過剰に取得し、デッキを肥大化させる傾向がありました。 これらの行動は、リスクと長期的な成長のバランスをとる専門家の戦略とは対照的です。 著者らは、サンプルサイズの小ささや、一般的なデッキ構築の知識を完全に排除できないことなど、研究の限界を認めています。 こうした制約があるにもかかわらず、この調査結果は、高度なAIモデルであっても、ゲームの最高難易度を攻略するために必要な複雑でリスクの高い意思決定には苦戦することを示しています。