Información clave
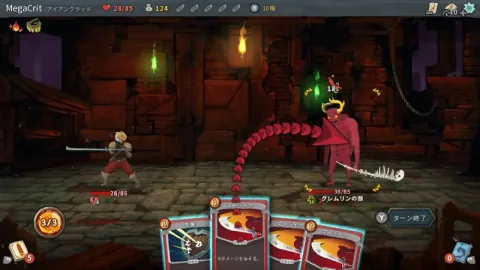
Un estudio reciente, aún no revisado por pares, realizado por Sander W. Keemink y Scott C. Lowe, evaluó a 20 modelos de lenguaje extenso (LLM) jugando a 'Slay the Spire' en el nivel de Ascensión 20.
Aunque algunos modelos lograron superar el Acto 1, el rendimiento cayó significativamente en las etapas posteriores, y solo un modelo logró la victoria contra el jefe final en todas las pruebas. Los investigadores utilizaron un entorno personalizado llamado SpireBench para permitir que los LLM interactuaran directamente con el juego. Para mitigar el conocimiento previo, el estudio reemplazó la terminología del juego.
El rendimiento se comparó con los datos históricos de Mega Crit y con cuatro streamers veteranos, revelando que, si bien los mejores LLM pueden superar a los jugadores promedio en combates a corto plazo, no alcanzan la competencia de un experto humano. El estudio atribuye el fracaso de los LLM a su estilo de juego excesivamente cauteloso. Los modelos priorizaron la preservación inmediata de los puntos de vida, eligiendo frecuentemente descansar en lugar de mejorar cartas y evitando los encuentros con enemigos de élite.
Además, los LLM tendían a adquirir demasiadas cartas, lo que sobrecargaba sus mazos. Estos comportamientos contrastan con las estrategias de los expertos, que equilibran el riesgo con el crecimiento a largo plazo. Los autores reconocen las limitaciones, incluyendo el pequeño tamaño de la muestra y la incapacidad de excluir completamente el conocimiento general sobre la construcción de mazos. A pesar de estas restricciones, los hallazgos destacan que incluso los modelos de IA avanzados tienen dificultades con la toma de decisiones compleja y de alto riesgo necesaria para dominar la mayor dificultad del juego.