Wichtige Informationen
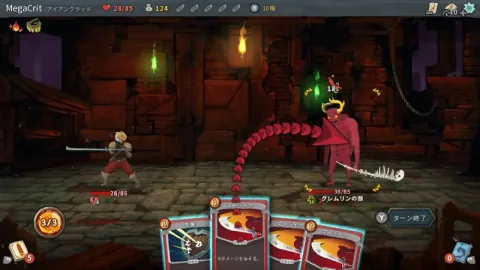
Eine aktuelle Preprint-Studie von Sander W. Keemink und Scott C. Lowe untersuchte 20 große Sprachmodelle (LLMs), die „Slay the Spire“ auf dem Schwierigkeitsgrad „Aufstieg 20“ spielten.
Während einige Modelle den ersten Akt erfolgreich abschlossen, ließ die Leistung in späteren Phasen deutlich nach; nur ein einziges Modell konnte über alle Testläufe hinweg einen Sieg gegen den Endboss erringen. Die Forscher nutzten eine benutzerdefinierte Umgebung namens SpireBench, um den LLMs die direkte Interaktion mit dem Spiel zu ermöglichen. Um Vorwissen auszuschließen, ersetzte die Studie die spielinterne Terminologie. Die Leistung wurde mit historischen Daten von Mega Crit und vier erfahrenen Streamern verglichen.
Dabei zeigte sich, dass Top-LLMs zwar im kurzfristigen Kampf besser abschneiden können als durchschnittliche Spieler, jedoch nicht das Niveau menschlicher Experten erreichen. Die Studie führt das Scheitern der LLMs auf ihren übermäßig vorsichtigen Spielstil zurück. Die Modelle priorisierten den sofortigen Erhalt von Lebenspunkten, wählten häufig Ruhephasen statt Karten-Upgrades und mieden Elite-Gegner.
Zudem neigten die LLMs dazu, zu viele Karten zu sammeln, was ihre Decks aufblähte. Diese Verhaltensweisen stehen im Kontrast zu Expertenstrategien, die Risiko und langfristiges Wachstum abwägen. Die Autoren räumen Einschränkungen ein, darunter kleine Stichprobengrößen und die Unmöglichkeit, allgemeines Wissen über Deckbau vollständig auszuschließen. Trotz dieser Einschränkungen verdeutlichen die Ergebnisse, dass selbst fortschrittliche KI-Modelle mit der komplexen Entscheidungsfindung unter hohem Druck, die für die Meisterung des höchsten Schwierigkeitsgrades erforderlich ist, zu kämpfen haben.